PostgreSQL Datenbankdesign für Vokabeltrainer

  • Themenstarter Themenstarter Xyz1
  • Beginndatum Beginndatum
X

Xyz1

Gast
Hallo!
Dieses Thema: http://www.java-forum.org/thema/vokabelanfrageprogramm.176632/ hat mich auf dieses Thema gebracht.
UI schaut im Moment so:

GdfLoTa.png


Ich muss mir jetzt ein Datenbankdesign überlegen. Das schaut im Moment so:
Java:
                sta.execute("CREATE TABLE IF NOT EXISTS " + name + " ("
                        + "id SERIAL PRIMARY KEY,"
                        + "a TEXT NOT NULL,"
                        + "b TEXT NOT NULL );");

Nun möchte ich aber die komplette Vokabelliste laden und speichern. Deshalb
wäre meine Frage, ob ich das Design so lassen kann.

Das Problem, was ich hätte, das man keine Reihen überschreiben kann.

Bearbeitung: Das oben ist quasi SQL-Standard für:
SQL:
id INT NOT NULL AUTO_INCREMENT PRIMARY KEY

Also alles recht straightforward.
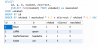
 
Also ich möchte mit SELECT * den Inhalt der Tabelle laden,
dann möchte ich die Tabelle ändern und komplett wieder speichern,
wenn ich aber lade und speichere, habe ich lauter doppelte Rows,
wenn ich versuche, den PK zu überschreiben, geht das nicht,
weil der PK eindeutig sein muss;
ich bräuchte eine Anweisung, die nur Rows übernimmt,
wenn "a != a und b != b",
ich weiß aber, dass so eine Operation aufwändig ist,
deshalb denk ich, das ganze Datenbankschema ist so noch
nicht in Ordnung.
Hättest du eine Idee, wie man "duplikat" Rows überschreiben kann?
Oder ist der Ansatz falsch?
Jede Idee wär mir da sehr willkommen.
 
Hinbekommen!
Mit der ID sollte sich nur die DB beschäftigen...
Del:
Java:
                for (int i = selectedRows.length - 1; i > -1; i--) {
                    sta.executeUpdate("DELETE FROM " + name + " WHERE id = " + MODEL.getValueAt(selectedRows[i], 0) + " ;");
                    MODEL.removeRow(selectedRows[i]);
                }
funktioniert (gut)

Laden:
Java:
                while (res.next()) {
                    ll.add(new String[]{res.getString(1), res.getString(2), res.getString(3)});
                }
funktioniert (gut)

Speichern:
Java:
                        sta.executeUpdate("INSERT INTO " + name + " (a, b) SELECT '" + MODEL.getValueAt(i, 1) + "', '" + MODEL.getValueAt(i, 2) + "' "
                                + "WHERE NOT EXISTS ( SELECT id, a, b FROM " + name + " WHERE a = '" + MODEL.getValueAt(i, 1) + "' and b = '" + MODEL.getValueAt(i, 2) + "' );");
funktioniert auch (gut)

Seht ihr noch etwas Besseres (was man verbessern könnte)?
 
Wozu eine Datenbank wenn du die immer komplett lesen und schreiben willst? Nimm eine Textdatei ist in dem Fall schneller.

Wenn Du wirklich mit Einer Datenbank arbeiten willst, dann liest du auch nur die Daten die angezeigt werden und du speicherst jeden Datensatz sobald er geändert wird und nicht mehrere auf einmal.
 
Danke für deine Antwort. Eigentlich geht's darum, meine Datenbankkenntnisse etwas aufzufrischen, darin bin ich nämlich etwas verrostet, sonst ich auch nicht hier fragen.^^ Und eine DB könnte beim Abfragen hinter nützlich sein.

Ich habe auch nicht tausende von Vokabeln (jedenfalls noch nicht).

Bearbeitung:
Genau, beim Abfragen ist das nützlich:
Code:
 id |   a   |   b   | richtig | falsch
----+-------+-------+---------+--------
  1 | hallo | tag   |       1 |      1
  3 | hsdak | sdfk  |       1 |      2
  4 | poiwe | fr    |       1 |      3
  5 | sdof  | opi   |       1 |      5
  7 | rrrr  | arrrr |       1 |      2
(5 Zeilen)

Frage die 5 schlechtesten ab:
Java:
ResultSet res = sta.executeQuery("SELECT id, a, b, 1.0 * richtig / falsch AS fak FROM " + name + " ORDER BY fak LIMIT 5;");

Gibt aus:
sdof
poiwe
hsdak
rrrr
hallo
🙂

Bearbeitung: Evtl. dann noch Random dazu....
 
Zuletzt bearbeitet von einem Moderator:
Genau, also wähle die 5 schlechtesten, bei gleichheit wähle die zuerst eingefügten, mische sie und frage in dieser Reihenfolge ab:
Java:
ResultSet res = sta.executeQuery("SELECT * FROM ( SELECT id, a, b, 1.0 * richtig / falsch AS fak FROM " + name + " ORDER BY fak, id LIMIT 5 ) AS derivedTable ORDER BY RANDOM();");

Beispiel:
Code:
 id |   a   |   b   | richtig | falsch
----+-------+-------+---------+--------
  1 | hallo | tag   |       1 |      1
  5 | sdof  | opi   |       1 |      5
  7 | rrrr  | arrrr |       1 |      2
  8 | a     | b     |       1 |      1
  9 | c     | d     |       1 |      1
 11 | g     | h     |       1 |      1
 10 | e     | f     |       1 |      6
(7 Zeilen)


sdof
hallo
e
a
rrrr

Ich kann nicht wissen, ab a vor e abgefragt wird, aber ich weiß, dass immer a und nicht c oder g dabei ist (denn a wurde vorher eingefügt). 🙂 Es sei denn, man beantwortet ein paar Mal richtig, aber das ist klar....

AAAAAA: Jetzt darf man auch ein paarmal schreiben.
 
Hättest du eine Idee, wie man "duplikat" Rows überschreiben kann?
Oder ist der Ansatz falsch?

Der Ansatz stimmt 🙂

Zum einen: Du solltest einen Unique-Constraint auf deine Felder legen. Wenn eine Vokabel-Übersetzung nur einmal vorkommen darf (schließe ich aus wenn a != a und b != b), dann sollte das dein DB-Schema auch abbilden:

SQL:
ALTER TABLE vokabeln ADD CONSTRAINT UNIQUE(a, b)

Wenn du das gemacht hast, kannst du mit ON DUPLICATE KEY arbeiten:

Beim speichern:
SQL:
INSERT INTO vokabeln (a, b) VALUES ('Haus', 'House'), ('Cat', 'Katze') ON DUPLICATE KEY UPDATE a = values.a, b = values.b

EDIT: P.S.: @Thallius hat mMn. teilweise recht: eine Relationale Datenbank ist für diesen Anwendungszeck vmtl. das falsche Werkzeug. Textdateien werden super schnell unhandlich wenn du Statistiken oder mehrere Sprachen unterstützen willst. Eine Graphen-Datenbank (wie z.B. Neo4J) ist da ein schlauerer Ansatz.
 
Beim speichern:
SQL:
INSERT INTO vokabeln (a, b) VALUES ('Haus', 'House'), ('Cat', 'Katze') ON DUPLICATE KEY UPDATE a = values.a, b = values.b

Aehm, überlegmal genau was da beim update eigentlich passieren soll 🙂

Gruß

Claus
 
Du kannst es so machen, dass es gar keine ID gibt sondern einen zusammengesetzten Primärschlüssel. Dieser besteht aus a und b.
 
Es funktioniert ja bereits.
Mit der Performance bin ich auch zufrieden.
Lediglich, wenn das mal jemand anderes außer ich benutzen soll,
die Installation von postgresql ist ein graus.
 
Frage:
Ich habe Anzahl richtig und Anzahl falsch.
Beide beginnen bei 1.
Beide werden hochgezählt.
Ist es sinnvoll, richtig / falsch zu rechnen und zu sortieren,
oder einfach richtig - falsch und sortieren,
oder noch etwas anderes?
(Logik?)

Es geht um die Abfrage eines Lernsatzes:
SQL:
SELECT * FROM ( SELECT id, a, b, 1.0 * richtig / falsch AS fak FROM Name ORDER BY fak, id LIMIT 5 ) AS derivedTable ORDER BY RANDOM();

speziell um das fak.

Logik: Hab ich Vokabeln ein paar Mal richtig beantwortet (>= 80 % richtig), dann sollen andere abgefragt werden. Hab ich alle ein paar Mal richtig beantwortet, dann wieder Alte. Kommen Neue dazu, dann...?
 
Jetzt zeigt sich das Ausmaß der Katastrophe:
Alle Fragen wurden 10mal richtig beantwortet.
Wenn ich 1 Frage 1mal falsch beantworte, muss ich sie bei der Subtraktion 1mal richtig beantworten.
Wenn ich 1 Frage 1mal falsch beantworte, muss ich sie bei der Division 5.0mal richtig beantworten. Differenz: 4.0
Wenn ich 1 Frage 2mal falsch beantworte, muss ich sie bei der Subtraktion 2mal richtig beantworten.
Wenn ich 1 Frage 2mal falsch beantworte, muss ich sie bei der Division 6.666667mal richtig beantworten. Differenz: 4.666667
Wenn ich 1 Frage 3mal falsch beantworte, muss ich sie bei der Subtraktion 3mal richtig beantworten.
Wenn ich 1 Frage 3mal falsch beantworte, muss ich sie bei der Division 7.5mal richtig beantworten. Differenz: 4.5
Wenn ich 1 Frage 4mal falsch beantworte, muss ich sie bei der Subtraktion 4mal richtig beantworten.
Wenn ich 1 Frage 4mal falsch beantworte, muss ich sie bei der Division 8.0mal richtig beantworten. Differenz: 4.0
Wenn ich 1 Frage 5mal falsch beantworte, muss ich sie bei der Subtraktion 5mal richtig beantworten.
Wenn ich 1 Frage 5mal falsch beantworte, muss ich sie bei der Division 8.333333mal richtig beantworten. Differenz: 3.333333
Wenn ich 1 Frage 6mal falsch beantworte, muss ich sie bei der Subtraktion 6mal richtig beantworten.
Wenn ich 1 Frage 6mal falsch beantworte, muss ich sie bei der Division 8.571428mal richtig beantworten. Differenz: 2.5714283
Wenn ich 1 Frage 7mal falsch beantworte, muss ich sie bei der Subtraktion 7mal richtig beantworten.
Wenn ich 1 Frage 7mal falsch beantworte, muss ich sie bei der Division 8.75mal richtig beantworten. Differenz: 1.75
Wenn ich 1 Frage 8mal falsch beantworte, muss ich sie bei der Subtraktion 8mal richtig beantworten.
Wenn ich 1 Frage 8mal falsch beantworte, muss ich sie bei der Division 8.888889mal richtig beantworten. Differenz: 0.8888893
Wenn ich 1 Frage 9mal falsch beantworte, muss ich sie bei der Subtraktion 9mal richtig beantworten.
Wenn ich 1 Frage 9mal falsch beantworte, muss ich sie bei der Division 9.0mal richtig beantworten. Differenz: 0.0
Wenn ich 1 Frage 10mal falsch beantworte, muss ich sie bei der Subtraktion 10mal richtig beantworten.
Wenn ich 1 Frage 10mal falsch beantworte, muss ich sie bei der Division 9.090909mal richtig beantworten. Differenz: -0.909091
:
3U2LMe9.png


Welches wäre denn ein gewünschtes Verhalten? Der Anstieg von f ist zu stark, so viel steht fest....
 
Wieso nicht einfach prozentual?
Das dachte ich mir auch. Wenn der User alle Vokabeln 5 mal richtig beantwortet hat, kannst du die 5 mal auch einfach rausrechnen.

EDIT:
Mal ne andere Frage:
[...]
SQL:
SELECT * FROM ( SELECT id, a, b, 1.0 * richtig / falsch AS fak FROM Name ORDER BY fak, id LIMIT 5 ) AS derivedTable ORDER BY RANDOM();
[...]

Wenn du dann eh nach RANDOM() sortierst, warum überhaupt fak berechnen?
Mal angenommen, dass das RANDOM() unbeabsichtigt ist, würde ich eher sowas nehmen:

SQL:
SELECT id, a, b FROM Name ORDER BY richtig / (richtig + falsch) ASC
 
Zuletzt bearbeitet:
Der Lerneffekt ist mit Random größer... wenn ich erst etwas lerne, was ich zwar schlecht, aber nicht am schlechtesten kann.
Also 42 kann ich nicht, dann bringt es nix, immer wieder 42 abzufragen, sondern stattdessen 37, was ich besser kann, und i.wann später 42.
------
Bin verwirrt. Wie meinst du das mit Prozentual?
1-((richtig+falsch)/richtig) ???
------
Das hätte doch denselben Effekt?
 
(richtig * 100) / (richtig + falsch) gibt Dir an wieviel prozent richtig gewesen sind. Da dieser Wert immer zwischen 0 und 100 liegt kannst du einfach sagen je niedriger der Wert umso wahrscheinlicher das er sie noch einmal fragen soll
 
Der Lerneffekt ist mit Random größer... wenn ich erst etwas lerne, was ich zwar schlecht, aber nicht am schlechtesten kann.
Also 42 kann ich nicht, dann bringt es nix, immer wieder 42 abzufragen, sondern stattdessen 37, was ich besser kann, und i.wann später 42.
Das macht schon Sinn, aber durch das RANDOM() wird das ORDER BY im Subselect komplett ausgehebelt. Du könntest genauso schreiben

SQL:
SELECT id, a, b FROM Name ORDER BY RANDOM()

P.S.: LIMIT nicht gesehen... ich sollte aufhören hier zu antworten, irgendwie bekomme ich keinen brauchbaren Beitrag zustande...
 
Okay, das würde so verlaufen:

TLc6aJX.png


Am Anfang hätte eine Vokabel 50 %, beantwortet sie 3mal richtig = 80 %, beantwortet sie 3mal falsch = 20 %

Okay, das ist gespiegelt, aber wärs dann immer richtig, oder wäre die Formel geeignet?
 
Naja, ob "3mal falsch, 20% Chance zum erneuten Abfragen" gut für den Lernerfolg ist, kann ich nicht bewerten. Ich denke es macht auch Sinn, den Zeitraum seit dem letzten Abfragen mit einzurechnen; Vokabeln lernt man schließlich auch durch Wiederholung. Aber da weiss ich zu wenig über das Lernverhalten des Gehirns :/
 
Das mit dem Prozentual funktioniert nicht!
Angenommen, a beantworte ich 10mal richtig = 91.67 %
b beantworte ich 10mal falsch = 8.33 %
Ich müsste b 120mal in Folge richtig beantworten, bevor mal wieder a abgefragt wird...
Dies verdeutlicht das Dilemma:

Jaafafu.png


Ich denke, es wird das beste sein, ich rech einfach richtig - falsch
 
Ja was ist denn daran falsch? Wenn ich eine Frage 10x richtig beantworte, dann brauche ich sie ja auch nicht mehr denn ich weiß sie ja. Wenn ich dagegen eine 10x falsch beantworte, dann kapier ich das wohl nicht und muss es entsprechend of wiederholen
 
Deswegen meinte ich ja: rechne die Zeit seit dem letzten Abfragen ein (oder einfacher die Anzahl der Abfragen). Vielleicht ist das sogar das stärkste Kriterium.

Ich habe mal ein bisschen rumprobiert:
query.png
"Baum" wird zuerst gefragt, weil das weniger Korrektheits-Anteil hat. Von den anderen werden aber die mit weniger Wiederholungen zuerst gefragt. An den Gewichtungsfaktoren kannst du jetzt rumspielen wie du magst.

Tabellendefinition:tabelle.png

P.S.: Das GROUP BY brauchts nicht unbedingt, da die Aggregatsfunktion im Subquery gekapselt ist.
 
Ja, aber das macht wenig Sinn. Wenn ich je 5 mal nach zwei Vokabeln A und B gefragt werde, A 5 mal richtig habe und B nur einmal, dann sollte ich, bis ich B gelernt habe, A trotzdem ab und zu gefragt werden, damit es mir nicht entfällt. Daher habe ich in meinem Beispiel die Zahl der Fragestellungen einbezogen.
 
Vielleicht könntest du auch ein Fächersystem einführen, also eine Vokabel kommt, wenn sie erstellt wird in Fach 1 und nach dem Abfragen in Fach 2. Dann dauert es 5 Tage und die Vokabel wird wieder abgefragt. Bei richtiger Antwort kommt sie in Fach 3, sonst wieder 1. Die Reihenfolge in der die Vokabeln, die überhaupt abgefragt werden, kannst du random wählen, denn wenn man das gut organisiert muss man jeden Tag höchstens 50 abfragen (selbst bei nem crashkurs). Dann merkt man sich die Vokabeln auch länger als wenn man jeden Tag dieselbe Vokabel abfragt. Je länger der Zeitraum seit der letzten Abfrage, desto höher dann auch der Zeitraum, den man sich die Vokabel generell merkt. Die mit der höchsten Quote an falschen Antworten sind meistens in Fach 1 und werden jeden Tag abgefragt.
 
Ja, aber das macht wenig Sinn. Wenn ich je 5 mal nach zwei Vokabeln A und B gefragt werde, A 5 mal richtig habe und B nur einmal, dann sollte ich, bis ich B gelernt habe, A trotzdem ab und zu gefragt werden, damit es mir nicht entfällt. Daher habe ich in meinem Beispiel die Zahl der Fragestellungen einbezogen.

Du sollst die ja auch gar nicht komplett ausschließen. Du sollst es gewichten. Z.b. Kannst du sagen die Wahrscheinlichkeit dass eine zu 100% richtig beantwortete Frage mit 5% Wahrscheinlichkeit gezogen wird, während die Wahrscheinlichkeit das eine zu 0% richtig beantwortete Frage bei 95% liegt ... etc
 
Ich würde auch dem Vorschlag von @SupressWarnings() folgen: ein Fehler bewirkt komplettes neu lernen, egal wie oft es schon richtig war. Das ist ein bewährtes System. Falls man anfangs eine viel zu lange Liste für das Fächersystem hat, würde ich das Problem dadurch lösen, dass zunächst nur eine kleine Teilmenge in das Fächersystem überführt wird. Sobald nur noch wenige Vokabeln ungefestigt sind, überführt man die nächste Teilmenge.
 
Linear ist quasi schon eine sehr feingranulare Fächerung.

Und berechnete Attribute ist doch ein No-go.
------
Ich danke alle für ihre Beiträge.
 
Bei einem Update könnte es "Konflikte" geben, wenn ich nicht alle anderen Attribute auch ändere.
Bspw. nCorrect ändert sich, dann nAsk und maxAsk auch, wenn ich es richtig seh.
Bei richtig u. falsch, kann ich ein Attribut "isoliert" ändern.
Jedenfalls, der Professor hat uns damals nur davor gewarnt.
Etwas rechnen kann das DBMS ja auch 😉 .

So, aber ich kann jetzt eigentlich mit dem Lernen beginnen, ich mache die Eingabe mit der Edit Distanz, >= 80 % ist richtig bei mir.
Also bei hallo wäre auch hallü richtig. 🙂
 
Inzwischen läuft es über einen Server, ich kann von überall, wo Java und die Anwendung installiert ist, darauf zugreifen - und hab auch schon mit dem Lernen begonnen.
Nun muss ich nicht nur Vokabeln lernen, sondern zB auch Formeln. Auf der linken Seite steht bspw.:
sig(t)
und auf der rechten Seite:
1/(1+e^(-t))
. Es wird zufällig die linke oder rechte Seite abgefragt. Frage mich jetzt, ob ein Vokabeltrainer auch zum Lernen von Formeln geeignet ist.
Ich kann auch ein paar Testdaten bereitstellen, falls ihr das bei euch auch laufen lassen wollt. Wie der Lernfortschritt berechnet werden soll, lässt sich mit echten Daten besser.
 
Bei Formeln wäre es schön wenn da ein Bild mit der Formel wäre und kein String mit Zirkumflex. Lässt sich das umsetzen?
 
*nachdenk* Wenn es mehrere solcher Formeln in .png gäbe, könnte man 5 oder so bei der Eingabe zur Auswahl stellen. Aber ob der Lerneffekt dann noch gegeben, das weiß ich nicht. 😳
Eine andere Möglichkeit wäre Handschrifterkennung --- nicht gerade das leichteste Gebiet.
 
Werd doch mal konkreter - anstatt einfach Buzzwords hier fallen zu lassen.

Und bitte bedenken, dass das über einen Server läuft.
Hat auch gedauert - den sicher zu bekommen. 😉
 
Mit Flying Saucer kannst du fortgeschrittene HTML-Dokumente anzeigen lassen, und MathJax ist bereits der Standart, was Formeln und Mathematikformatierung im Internet angeht.

Das ueberpruefen einer Antwort ist schon etwas schwieriger.
 
Wer es mal testen möchte:
Code:
Archive:  Vokabeln4.zip
 Length   Method    Size  Cmpr    Date    Time   CRC-32   Name
--------  ------  ------- ---- ---------- ----- --------  ----
       0  Stored        0   0% 2017-03-01 10:01 00000000  Vokabeln4/
       0  Stored        0   0% 2017-03-01 09:54 00000000  Vokabeln4/lib/
  680445  Defl:N   646516   5% 2017-03-01 09:54 fa71f6c8  Vokabeln4/lib/postgresql-9.4.1212.jar
   13384  Defl:N     6535  51% 2017-03-01 09:54 62e4d9d1  Vokabeln4/Vokabeln.jar
--------          -------  ---                            -------
  693829           653051   6%                            4 files

1. zip Datei entpacken
2. bitte java -jar Vokabeln in der Kommandozeile aufrufen
3. postgresql installieren...
4. Datenbank 'vokabeln' anlegen
5. Benutzername eingeben
6. Passwort eingeben
7. Kommandozeile beobachten, keine Ausgabe = kein Fehler 🙂

3.
https://wiki.postgresql.org/wiki/Detailed_installation_guides
https://wiki.ubuntuusers.de/PostgreSQL/

8. Spaß haben 🙂
 

Anhänge

Bearbeitung (typo, Reihenfolge, Ergänzung...):
1. postgresql installieren...
2. Datenbank 'vokabeln' anlegen
3. zip Datei entpacken
4. bitte java -jar Vokabeln.jar in der Kommandozeile aufrufen
5. Benutzername eingeben
6. Passwort eingeben
7. Kommandozeile beobachten, keine Ausgabe = kein Fehler
8. Spaß haben 🙂

1. Links zu 1. siehe bitte oben

9. BITTE MAL 'NE RÜCKMELDUNG GEBEN!!!!
 
Mit Flying Saucer kannst du fortgeschrittene HTML-Dokumente anzeigen lassen, und MathJax ist bereits der Standart, was Formeln und Mathematikformatierung im Internet angeht.
Ja, aber ohne die von @DerWissende erwähnte Handschriftenerkennung, muss der User trotzdem eine Syntax verwenden, welche stark einer Programmiersprache ähnelt. Und dabei ist der Zirkumflex schwer- bis unabdingbar.

Das ueberpruefen einer Antwort ist schon etwas schwieriger.
Etwas? Enorm! Mathematisch gesehen liegen zwei Therme vor deren Äquivalenz geprüft werden muss. Das mag für simple Terme funktionieren, wird aber schon bei fortgeschrittenen Gleichungen rightig, richtig super eklig.
 
Das ueberpruefen einer Antwort ist schon etwas schwieriger.
Ich würde dem Bediener nur die Antwort anzeigen und ihn selbst entscheiden lassen, ob es als falsch oder richtig gewertet werden soll. Das würde ich bereits bei Vokabeln so machen, wo die Überprüfung eigentlich einfach machbar wäre. Manchmal gibt es aber mehrere korrekte Übersetzungen und zum sinnvollen Lernen ist es meines Erachtens auch effizienter, die Vokabel nicht nur alleinstehend, sondern auch in Verbindung mit einem vollständigen Satz oder Satzfragment zu trainieren. Da würden fehlerhafte Computerbewertungen nur frustrieren. Ich glaube, durch die Computerbewertung schränkt man die Nutzungsmöglichkeiten nur ein.
 
Hausaufgabenportale wie z.B. "WebAssign" benutzen MathJax die der Nutzer dann als Antwort absenden kann. In diesem Fall scheint es halt so, als ob mehrere Antwortmoeglichkeiten einfach gecheckt werden, aber auch nicht wirklich alle.

Man koennte Matheaufgaben dann z.B. auch nur so stellen, dass es auch wirklich nur zu einer Loesung bringt. z.B. gibt es unendlich viele Antworten fuer die Ableitung von f(x) = tan(x) * sin^2(2x)-3x^3, aber wenn man nun fragt, was die Ableitung der Funktion mit x = 0 ist, dann ist es schon viel spezifischer, weil der Nutzer auch nur einen bestimmten Wert eingeben muss. 1 = 6/6 = 8/8, oder 2-1 = 1, aber der Punkt ist ja, dass wir nun mit Zahlen arbeiten, und nicht mit Funktionen.

Es gibt auch viel schlechtere Portale als WebAssign, die ich selber mal nutzen musste. WileyPlus z.B. hat nicht mal irgendein MathJax Support, und MyMathLab fragt immer nach aufgerundeten Zahlen. Es ist also kein Problem dass man hier leicht loesen koennte.

Jeder dieser Portale hatte bis jetzt Nachteile was Antwortmoeglichkeiten angeht. Konzeptfragen wie z.B. in Experimentalphysik I, II oder III sind dann meistens multiple-choice, und Aufgaben die mit Mathematik zu tun haben sind dann auch meistens so gestellt, dass der Nutzer weiss, man hat nur eine bestimmte Moeglichkeit wie man die Frage beantwortet.

Beispiel:

nit.jpg

Wie man sieht, gibt man dem Nutzer nur eine bestimmte Auswahlmoeglichkeit fuer bestimmte Konzeptfragen in Physik, z.B.

Ich weiss jetzt nicht was die Handschrift damit zu tun hat, aber das waere jetzt so meine Herangehensweise.
 
Wups, Doppelpost. Aber ja, die Antworten in einer bestimmten Form zu parsen und wieder ueberpruefen.. ob man dann HTML-Tag zu HTML-Tag ueberprueft, weiss ich jetzt nicht genau.
 
Wer hat es denn mal getestet, und kann wenigstens mal sagen, yo läuft / läuft nicht ????

Ich weiß, dass das Zugriffsmanagement von postgre kein Zuckerschlecken ist:
https://www.digitalocean.com/commun...e-grant-permissions-in-postgresql-on-a-vps--2
Aber ihr könnt auch einfach sudo apt-get install postgresql machen und euch mit postgres ohne Passwort anmelden.
Solange kein host Eintrag in der config Datei ist, ist alles gut.

Zu den Formel: Es gibt nur 3 Möglichkeiten:
1. (genaue) Formel in Textform eingeben
2. 5 unterschiedliche Formeln stehen zur Auswahl (der Lerneffekt ist nicht so super, öfter abfragen)
3. eine Formeln wird aus kleineren Bausteinen zusammengesetzt (der Lerneffekt ist besser, aber auch nicht gut)
(4. Handschrifterkennung: Zwei .png s / bzw. Shapes werden miteinander verglichen [kommt auf den Lerntyp an])

Dann... Informatiker finden ja die lineare Schreibweise super, dann brauch ich mir den Aufwand eigentlich auch nicht machen.

@Nuiton : Hier nix Physikforum 😀
 
Bearbeitung:
http://winfuture.de/news,89461.html
Shape Recognition
Für Windows-10-Nutzer wird es ebenfalls eine praktische Neuerung geben. OneNote erhält auf vielfachen Nutzerwunsch die Erkennung von Mustern und Formen, Shape Recognition genannt. Mit Hilfe der Shape Recognition wird aus einem freihändig unförmig gezeichneten Kreis ein exakter Kreis [...]

http://winfuture.de/news,89461.html#sci1445366870,1024,963,13912

Zufällig kenne ich jemanden, der an One Note arbeitet , den kann ich ja mal fragen, wie das mit der Erkennung so läuft 😀

Ne, mal ernsthaft, das ist nicht das leichteste Gebiet.
 

Zurück
Oben