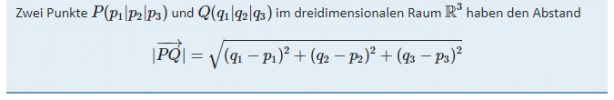
Erste Schritte Wie schnell ist LinkedHashMap im Vergleich zur ArrayList, wenn alle Entries durchlaufen werden?

Kamil1

Gesperrter Benutzer
Hi, ich bastle gerade ein Werkzeug für EliteDangerous und möchte nicht gleich einen bösen Schnitzer einbauen...

Gedacht hatte ich mir die Datenstruktur so:
Java:
import java.util.LinkedHashMap;

public class EliteTr {
    public static class Commodity {
        Station station = null;
        long updated_at;
        long id;
        boolean toBuy;
        int price;
        int amount;
    }

    public static class Station {
        LinkedHashMap<Long, Commodity> commodities = new LinkedHashMap<>();
        long updated_at;
        long id;
    }

    private LinkedHashMap<Long, Station> stations = new LinkedHashMap<>();

    public static void main(String[] args) {
        System.out.println("hello world");
    }
}

Es gibt ca. 1.000.000 Stationen und pro Station jeweils ca. 30 Commoditys. Später sollen alle Stationen und jedes Commodity durchlaufen werden und mit allen Commoditys aller anderen Stationen verglichen werden. Der Aufwand wäre hierfür ca. (1.000.000*30)². Ich kann aber auch Filter einsetzen, wenn das zu viel würde.

Jetzt frage ich mich, mit welcher Datenstruktur ich am schnellsten alle Stationen durchlaufen kann... Wenn gewünscht, kann ich auch den Algo gerade durch Pseudocode skizzieren.

Danke für eure weisen Antworten 🙂
 
Eine Arraylist wäre klarerweise schneller (und verwende keine Streams, die sind elendig langsam), aber das Durchlaufen ist in beiden Fällen dein kleinstes Problem.
Dein Zeitproblem dürfte eher mit dem Vorhaben an sich in Verbindung zu bringen sein.
Filter sind immer gut.
 
Ansonsten denke ich, dass wäre ein Job für eine DB. Man müsste ja ansonsten erst mal die ganzen Datenstrukturen und Objekte aufbauen und im Speicher halten. Eine DB kann mit entsprechenden Indizes usw. ultraschnell vergleichen oder aggregieren.
Naja, den Algo per Datenbankanfragen zu machen, ist wohl die denkbar inperformanteste Möglichkeit. Dennoch danke ich auch dir für deine Wortmeldung.

aber das Durchlaufen ist in beiden Fällen dein kleinstes Problem.
Doch, genau um das geht es in diesem Thema. Falls du nur mal Dampf ablassen wolltest, dann danke ich dir nicht...
 
Den Algo stelle ich mir ungefähr so vor:
Java:
import java.util.LinkedHashMap;

public class EliteTr {
    public static class Commodity {
        Station station = null;
        long updated_at;
        long id;
        boolean toBuy;
        int price;
        int amount;
    }

    public static class Station {
        LinkedHashMap<Long, Commodity> commodities = new LinkedHashMap<>();
        long updated_at;
        long id;
    }

    private LinkedHashMap<Long, Station> stations = new LinkedHashMap<>();

    public void algo() {
        for (Station s1 : stations.values()) {
            for (Station s2 : stations.values()) {
                for (Commodity c1 : s1.commodities.values()) {
                    Commodity c2 = s2.commodities.get(c1.id);
                    if (c2.price - c1.price > ...){
                        // add c1 and c2 to result
                    }
                }
            }
        }
    }

    public static void main(String[] args) {
        new EliteTr().algo();
    }
}

Und, wie man schön sieht, sind es jetzt, noch ohne Filterung, nur noch 1.000.000*1.000.000*30=nur noch 30 Milliarden.

Dennoch bin ich natürlich bestrebt, die Laufzeiten der for-each es möglichst gering zu halten...
 
Doch, genau um das geht es in diesem Thema. Falls du nur mal Dampf ablassen wolltest, dann danke ich dir nicht...
Also darfst du mir danken, denn ich steh dazu. Das Durchlaufen macht in jedem Fall nur einen kleinen Bruchteil der benötigten Zeit aus, die Vergleiche und daraus resultierenden Folgen sind das Hauptproblem.
Deine Map kannst du der Performance wegen ja in was performanteres reinkopieren als eine LinkedHashMap, wenn du magst, aber es wird nicht viel an der Laufzeit ändern.
 
Naja, den Algo per Datenbankanfragen zu machen, ist wohl die denkbar inperformanteste Möglichkeit. Dennoch danke ich auch dir für deine Wortmeldung.

Datenbank dafür kann durchaus das schnellste sein, da die für genau sowas optimiert ist. Das bekommt man natürlich auch in Java-Code hin, aber der Aufwand dafür ist vermutlich nicht lohnenswert und braucht einiges an Vorwissen, was deutlich über "ArrayList vs LinkedHashMap" hinaus geht.

Doch, genau um das geht es in diesem Thema. Falls du nur mal Dampf ablassen wolltest, dann danke ich dir nicht...
Darum geht das Thema, weil es ein typische XY-Problem ist 😉 Einfach aufgrund der Laufzeitkomplexität des Problems ist es nahezu egal ob ArrayList oder LinkedHashMap.

An deinen Beispielcode sieht man btw schon, dass dein Ansatz wahrscheinlich nicht der sinnvollste dafür ist, und man das O(N^2) in Richtung O(N) optimieren kann...
 
Darum geht das Thema, weil es ein typische XY-Problem ist 😉 Einfach aufgrund der Laufzeitkomplexität des Problems ist es nahezu egal ob ArrayList oder LinkedHashMap.

An deinen Beispielcode sieht man btw schon, dass dein Ansatz wahrscheinlich nicht der sinnvollste dafür ist, und man das O(N^2) in Richtung O(N) optimieren kann...
Wie gesagt, ich kann noch filtern, dadurch erhalte ich aber nur noch annähernd beste Ergebnisse. Deshalb geht es erstmal darum, die schnellstmögliche Datenstruktur zu finden.
 
Wie gesagt, ich kann noch filtern, dadurch erhalte ich aber nur noch annähernd beste Ergebnisse. Deshalb geht es erstmal darum, die schnellstmögliche Datenstruktur zu finden.
Wie (implizit) gesagt: der Ansatz ist Mist, ob mit oder ohne filtern. Bei solchen Schleifen ist die Datenstruktur völlig egal, ob es 30 oder 25 Jahre Dauert, interessiert am Ende niemanden.

Wenn du einmal die eigentliche Problemstellung sagen würdest, könnte man dir garantierte einen sinnvollen Algorithmus und dafür passende Datenstrukturen nennen.
 
Dem Code-Ausschnitt oben nach zu urteilen, denke ich, dass er die Marktlage analysieren will, Preise vergleichen usw.
Es gibt schon einen Grund, warum das in solchen Spielen immer nur pro Cluster passiert und nicht gleich über das gesamte Universum.
 
Datenbank dafür kann durchaus das schnellste sein, da die für genau sowas optimiert ist.
Ja, das war auch mein Gedanke - spätestens wenn die Filter, die denkbar sind, bekannt sind.

Aber gerade die Verknüpfung ist da (aus meiner Sicht) ja hoch optimiert - also das, was da in den Schleifen als Nachschlagen der Map zu finden ist.

Hat aber den Nachteil: Da steht und fällt alles mit dem Hauptspeicher. Ohne Filter wird der Hauptspeicherbedarf kaum zu decken sein. Daher hatte ich auch erst einmal nichts in der Art geschrieben.
 
An den Speicher hab ich noch gar nicht gedacht 🙂
Auf jeden Fall wär's sinnvoll, die Unmenge an Daten erst mal in kleine Pakete aufzuteilen, zu filtern, aus jedem Paket die besten und schlechtesten Ergebnisse zu ermitteln und dann nur noch die zu vergleichen.

Wie gesagt, ob nun LinkedHashMap oder ArrayList ist die unwichtigste aller Fragen.
 
Eine Antwort auf deine Frage steht oben:
Eine Arraylist wäre klarerweise schneller

Nur ist es es eben völlig egal ob ArrayList oder LinkedHashMap.
Das ist ungefähr so wie zu fragen, ob zu Inlineskates oder Skateboard schneller ist, wenn du möglichst schnell nach Südamerika bringen muss. Ist halt beides scheiße.

Algorithmische Komplexität wird man eben nicht durch schnellere Datenstrukturen los, nur durch einen besseren Algorithmus – und den gibt es für dein Problem garantiert.
 
Deswegen bin ich mittlerweile fast ausschließlich nur noch auf Stackoverflow unterwegs. Und seitdem ich mühsam genügend Reputation aufgebaut habe, um Fragen auch selber zu schließen (selbstverständlich mit Begründung), macht es auch richtig Spaß. Sobald eine Frage nicht eindeutig formuliert ist, sodass man noch diverse Sachen nachfragen müsste und in einen Dialog mit dem Fragenden treten muss oder Annahmen über das Problem oder den Kontext treffen muss, um eine Antwort zu liefern, die andere dann aber nicht als Antwort verifizieren können (weil sie dieselben Annahmen treffen müssten), heißt es ab jetzt einfach nur noch: "Downvote, close and move on."
Ein paar Mal hatte ich mir auch beim Java Forum eine Möglichkeit zum Downvoten gewünscht oder eine community-basierte Moderation.
 
Ja, mich hatte es auch eine Zeit dann zu SO gezogen. Gerade, dass so viele Diskussionen einfach nicht stattfinden ist positiv.

Aber ich mache dieses Forum zu viel in kleinen Pausen und schlicht zu entspannt - das würde bei SO direkt 'bestraft'. So wie hier würde ich z.B. auf SO auch nie schreiben. Hat also alles seine Vor- und Nachteile (in meinen Augen).
 
Ich grüße euch 🎃

Ich hab jetzt genauere Daten. Das Universum hat doch "nur" ca. 200.000 Stationen und ca. 6.500.000 Commodities, d. h. ca. 32,5 Waren pro Station.

Jede Station hat eine x,y,z-Koordinate und zwei Stationen gelten als verbunden, gdw. ihre Entfernung nicht größer als 30 ist.

Satz des Pythagoras:
1635680718614.png

Ich weiß nicht, wie ihr dabei durch einen "besseren" Algorithmus O(n²) vermeiden wollt, aber ich lasse mich gern überraschen.

@mihe7 Bei einer Station A soll eine Ware W eingekauft werden, und bei einer Station B, nicht weiter als 30 entfernt, soll die Ware W gewinnbringend wieder verkauft werden. Gesucht ist der profitabelste Handel für alle Stationen.
 
Ud in welchem Wertebereich sind die x,y und z Koordinaten und wie ist die Verteilung? Man kann da bestimmt auch gut vorab aussortieren bzw. Gruppen bilden um weniger Punkt prüfen zu müssen. Das würde dann auch bei relationalen Datenbank helfen (Ausfiltern von Dingen, die man nicht mehr im Detail prüfen muss) und beim Ablauf wäre dies ein Vorsortieren in etwas, das man "Raumsektoren" nennen könnte.

Damit hat man zwar immer noch ein O(n²), aber das n ist halt deutlich kleiner. Und das kann durchaus ausschlaggebend sein um eben Laufzeit hi zu bekommen, der bei dem gegebenen n noch akzeptabel sein könnte bei entsprechender Rechenpower. Wenn Raumsektoren zu prüfen sind, ist das z.B. sehr gut parallelisieren - auch über mehrere Computer.
 
Habe es hinbekommen und es läuft auch ca. nur ne Minute... Hier ist mal der ausformulierte Algo:
Java:
import com.google.gson.Gson;
import com.google.gson.JsonArray;
import com.google.gson.JsonElement;
import com.google.gson.JsonObject;
import org.apache.commons.csv.CSVFormat;
import org.apache.commons.csv.CSVParser;
import org.apache.commons.csv.CSVRecord;

import java.io.*;
import java.net.URL;
import java.net.URLConnection;
import java.util.*;
import java.util.zip.GZIPInputStream;

public class EliteTr {
    public static class Commodity {
        long id;
        String name;
        String category;

        @Override
        public String toString() {
            return "Commodity{" +
                    "id=" + id +
                    ", name='" + name + '\'' +
                    ", category='" + category + '\'' +
                    '}';
        }
    }

    public static class Goods {
        Station station = null;
        Commodity commodity = null;
        long updated_at;
        long id;
        boolean toBuy;
        int price;
        int amount;

        @Override
        public String toString() {
            return "Goods{" +
                    "station=" + station +
                    ", commodity=" + commodity +
                    ", updated_at=" + updated_at +
                    ", id=" + id +
                    ", toBuy=" + toBuy +
                    ", price=" + price +
                    ", amount=" + amount +
                    '}';
        }
    }

    public static class Station {
        HashMap<Long, Goods> boughtMap = new HashMap<>();
        ArrayList<Goods> boughtList = new ArrayList<>();
        HashMap<Long, Goods> sellMap = new HashMap<>();
        ArrayList<Goods> sellList = new ArrayList<>();
        long updated_at;
        long id;
        long system_id;
        String name;
        System1 system1;
        boolean max_landing_pad_size_l;

        void addGoods(Goods g) {
            if (g.toBuy) {
                boughtMap.put(g.commodity.id, g);
                boughtList.add(g);
            } else {
                sellMap.put(g.commodity.id, g);
                sellList.add(g);
            }
        }

        boolean hasGoods() {
            return !(boughtMap.isEmpty() && sellMap.isEmpty());
        }

        boolean hasSellGoods() {
            return !sellMap.isEmpty();
        }

        boolean distanceFilter(Station s2) {
            final double maxLys = 20;
            final System1 a = this.system1;
            final System1 b = s2.system1;
            return Math.sqrt((a.x - b.x) * (a.x - b.x) + (a.y - b.y) * (a.y - b.y) + (a.z - b.z) * (a.z - b.z)) <= maxLys;
        }

        @Override
        public String toString() {
            return "Station{" +
                    "updated_at=" + updated_at +
                    ", id=" + id +
                    ", system_id=" + system_id +
                    ", name='" + name + '\'' +
                    ", system1=" + system1 +
                    ", max_landing_pad_size_l=" + max_landing_pad_size_l +
                    '}';
        }
    }

    public static class System1 {
        long updated_at;
        long id;
        String name;
        float x, y, z;

        @Override
        public String toString() {
            return "System1{" +
                    "updated_at=" + updated_at +
                    ", id=" + id +
                    ", name='" + name + '\'' +
                    ", x=" + x +
                    ", y=" + y +
                    ", z=" + z +
                    '}';
        }
    }

    private final HashMap<Long, Station> stationsMap = new HashMap<>();
    private final ArrayList<Station> stationsList = new ArrayList<>();

    public void addStation(Station s) {
        stationsMap.put(s.id, s);
        stationsList.add(s);
    }

    public void download() {
        // magic
    }

    public void download(String fn) {
        // magic
    }

    public void addAll() {
        // magic
    }

    public void cleanStations() {
        long removedCounter = 0;
        for (Iterator<Station> iter = stationsList.iterator(); iter.hasNext(); ) {
            Station s = iter.next();
            if (!s.max_landing_pad_size_l || !s.hasGoods()) {
                stationsMap.remove(s.id);
                iter.remove();
                removedCounter++;
            }
        }
        System.out.println("removedCounter = " + removedCounter);
        System.out.println("stationsMap = " + stationsMap.size());
        System.out.println("stationsList = " + stationsList.size());
    }

    public void runAlgo() {
        ArrayList<Object[]> results = new ArrayList<>();
        long counter = 0;
        for (Station s1 : stationsList) {
            if (s1.hasSellGoods()) {
                for (Station s2 : stationsList) {
                    if (s1.distanceFilter(s2)) {
                        for (Goods g1 : s1.sellList) {
                            Goods g2 = s2.boughtMap.get(g1.commodity.id);
                            if (g2 != null) {
                                counter++;
                                if (counter % 1_000_000 == 0) {
                                    System.out.println("counter = " + counter);
                                }
                                if (g2.price - g1.price > 0) {
                                    results.add(new Object[]{g1, g2, g2.price - g1.price});
                                }
                            }
                        }
                    }
                }
            }
        }
        System.out.println("counter = " + counter);
        results.sort(Comparator.comparingInt((Object[] o) -> (int) o[2]).reversed());
        System.out.println("results = " + results.size());
        for (int i = 0; i < 10; i++) {
            System.out.println(i + " = " + Arrays.toString(results.get(i)));
        }
    }

    public static void main(String[] args) {
        EliteTr tr = new EliteTr();
        tr.addAll();
        tr.cleanStations();
        tr.runAlgo();
    }
}

Ausgabe:
Code:
systemsMap.size() = 20593
[id, edsm_id, name, x, y, z, population, is_populated, government_id, government, allegiance_id, allegiance, security_id, security, primary_economy_id, primary_economy, power, power_state, power_state_id, needs_permit, updated_at, minor_factions_updated_at, simbad_ref, controlling_minor_faction_id, controlling_minor_faction, reserve_type_id, reserve_type, ed_system_address]
systemsMap.size() = 196903
stationsMap.size() = 145427
commoditiesMap.size() = 374
[id, station_id, commodity_id, supply, supply_bracket, buy_price, sell_price, demand, demand_bracket, collected_at]
counter = 1072393
removedCounter = 135178
stationsMap = 10249
stationsList = 10249
counter = 1000000
counter = 1629119
results = 96447
0 = ...

Process finished with exit code 0

Vielleicht kann immer noch etwas verbessert werden, was ich aber gerade nicht sehe ... 😉
 
Das ganze kannst du noch auf wesentlich unter eine Sekunde bekommen.
Stichwort: Spatial Acceleration Structures -> z.B. Octree und dann einfache k-Nearest Neighbor Queries mit der "Bounding-Box" einer Kugel um jede Station.
Das Problem ist: Du vergleichst aktuell jede Station mit jeder anderen Station. Das ist völlig unnötig.
 
Spatial Acceleration Structures -> z.B. Octree und dann einfache k-Nearest Neighbor Queries mit der "Bounding-Box" einer Kugel um jede Station
Ja, das Problem wird sein, diese Struktur vorzubereiten. Ich denke, das geht nicht unter n²... oder n²/2...

Ein weiteres Problem ist, dass ich keinen Zugang zur Fachliteratur in diese Richtung habe. 🙁
 
Mit einem range tree lässt sich eine 3D-Bereichsanfrage in O((log n)³ + a) durchführen, wobei das a für die Ergebnisgröße steht.
 
Hier ist eine Octree-Implementierung mit "Radius"-Suche, die ich mal vor ein paar Jahren gebaut hatte:
Java:
import java.util.ArrayList;
import java.util.List;
public class OctreeNode<E extends SpatialObject> {
  public static interface SpatialObject { 
    float x();
    float y();
    float z();
  }
  // optimal values depend on how much faster iterating a linear list
  // is compared to descending into an octree child.
  private static final int MAX_OBJECTS_PER_NODE = 8;
  private final float minX, minY, minZ, maxX, maxY, maxZ;
  private ArrayList<E> objects;
  private OctreeNode<E>[] children;
  public OctreeNode(float minX, float minY, float minZ, float maxX, float maxY, float maxZ) {
    this.minX = minX;
    this.minY = minY;
    this.minZ = minZ;
    this.maxX = maxX;
    this.maxY = maxY;
    this.maxZ = maxZ;
  }
  private void split() {
    children = new OctreeNode[8];
    float cx = (minX + maxX) * 0.5f, cy = (minY + maxY) * 0.5f, cz = (minZ + maxZ) * 0.5f;
    children[0] = new OctreeNode<E>(minX, minY, minZ, cx, cy, cz);
    children[1] = new OctreeNode<E>(cx, minY, minZ, maxX, cy, cz);
    children[2] = new OctreeNode<E>(minX, cy, minZ, cx, maxY, cz);
    children[3] = new OctreeNode<E>(cx, cy, minZ, maxX, maxY, cz);
    children[4] = new OctreeNode<E>(minX, minY, cz, cx, cy, maxZ);
    children[5] = new OctreeNode<E>(cx, minY, cz, maxX, cy, maxZ);
    children[6] = new OctreeNode<E>(minX, cy, cz, cx, maxY, maxZ);
    children[7] = new OctreeNode<E>(cx, cy, cz, maxX, maxY, maxZ);
  }
  private void insertIntoChild(E o) {
    children[octant(o.x(), o.y(), o.z())].insert(o);
  }
  private int octant(float x, float y, float z) {
    float cx = (minX + maxX) * 0.5f, cy = (minY + maxY) * 0.5f, cz = (minZ + maxZ) * 0.5f;
    return (x < cx ? 0 : 1) | (y < cy ? 0 : 2) | (z < cz ? 0 : 4);
  }

  /**
   * Insert the given object into the octree.
   */
  public void insert(E object) {
    if (children != null) {
      insertIntoChild(object);
    } else  if (objects != null && objects.size() == MAX_OBJECTS_PER_NODE) {
      split();
      for (int i = 0; i < objects.size(); i++)
        insertIntoChild(objects.get(i));
      objects = null;
      insertIntoChild(object);
    } else {
      if (objects == null)
        objects = new ArrayList<E>(MAX_OBJECTS_PER_NODE);
      objects.add(object);
    }
  }
  /**
   * Search all objects within a radius (Euclidean distance) <code>r</code> around
   * <code>(x, y, z)</code> and store them in <code>result</code>.
   */
  public void search(float x, float y, float z, float r, List<E> result) {
    if (x < minX - r || x > maxX + r || y < minY - r || y > maxY + r || z < minZ - r || z > maxZ + r)
      return;
    if (children != null) {
      for (int i = octant(x, y, z), c = 0; c < 8; i = (i + 1) & 7, c++)
        children[i].search(x, y, z, r, result);
    } else if (objects != null) {
      float r2 = r * r;
      for (int i = 0; i < objects.size(); i++) {
        E o = (E) objects.get(i);
        float dx = o.x() - x, dy = o.y() - y, dz = o.z() - z;
        float d2 = dx * dx + dy * dy + dz * dz;
        if (d2 < r2)
          result.add(o);
      }
    }
  }
}
Die Objekte, die du da einfügst, müssen SpatialObject implementieren, also müssen angeben, wie ihre x, y und z Koordinaten sind.
Objekte haben keine Ausdehnung, sind also einfach nur Punkte.
 
Danke 😀 ... jetzt weiß ich endlich, wieso diverse Websites auf diverse Anfragen so schnelle Antworten generieren können...

jetzt nur noch verstehen und in meine Anwendung integrieren. 🙂
 
Wenn das Ausmaß des Universums bekannt/fix ist, kann man auch einen ganz ähnlichen Weg einschlagen, der nicht die Zahl der Objekte sondern die Maße der Bounding-Box begrenzt. Dann kann man aus der Koordinate einen Schlüssel (a la QuadKey) berechnen, den man für eine HashMap verwenden könnte.
 
Wenn das Ausmaß des Universums bekannt/fix ist, kann man auch einen ganz ähnlichen Weg einschlagen, der nicht die Zahl der Objekte sondern die Maße der Bounding-Box begrenzt. Dann kann man aus der Koordinate einen Schlüssel (a la QuadKey) berechnen, den man für eine HashMap verwenden könnte.
Jupp, das hört glaube ich auf den Begriff "Spatial Hashing".
Also die Koordinaten der Objekte entsprechend des maximalen Suchradius diskretisieren, so dass garantiert ist, dass zwei als "benachbart" geltende Objekte (Entfernung innerhalb des Suchradius) niemals mehr als eine diskrete Koordinate voneinander entfernt sind, so dass Lookups mit solchen +1/-1 Offsets in der HashMap effizient möglich sind, um potenzielle Nachbarn zu finden.
Eine HashMap bietet dann gegenüber einem einfachen Grid noch den Vorteil, möglichst "sparse" (also dünn besetzt) zu sein. wenn es relativ viele freie/unbesetzte Zellen gibt, und somit speichereffizienter zu sein.
 
Naja, du diskrtisierst die Koordinaten deiner Objekte entsprechend deines Suchradius', so dass dein Suchradius <= 1 diskrete Länge/Einheit ist. Da sind dann die Ränder egal.
Also, selbst wenn ein Objekt ganz am "rechten Rand" einer Zelle liegt, dann kann ein benachbartes Objekt nur noch höchstens am rechten Rand "rechten" Zelle, also mit Offset (+1, 0), liegen.
 
Die Idee ist, die Größe der Zellen des Grids so zu wählen, dass eine Suche nach benachbarten Objekten einfach wird durch "Sampling" der direkt benachbarten Zellen.
Wenn Objekt A also in Zelle X (hier mal 2-dimensional) liegt, dann brauchst du "nur" die acht Zellen (in 2D) um X herum nach potenziellen Nachbarn abzusuchen, da weiter weg entfernte Zellen nicht mehr innerhalb des Suchradius liegen würden.
Das Ganze ist natürlich nur dann effizient, wenn der Suchradius signifikant kleiner ist als der durchschnittliche Abstand aller Objekte zueinander.
 

Neue Themen


Zurück
Oben